Imagine un mundo en el que las máquinas inteligentes superen con facilidad a los seres humanos en una amplia gama de tareas, desentrañando conceptos complejos y ecuaciones matemáticas en segundos, y dando vida a productos e ideas creativas que antes parecían inseparables de la mente humana.
Esta es una de las formas en que la "superinteligencia", o inteligencia artificial general, podría manifestarse si los investigadores logran escalar los grandes modelos de lenguaje hasta este umbral.
Los investigadores continúan debatiendo si los grandes modelos de lenguaje pueden alcanzar la superinteligencia, pero otros tienen preocupaciones aún mayores.

No leas más noticias. Entiéndelas.
En Epoch Times Español queremos estar en contacto directo contigo
Seleccionamos para ti lo que de verdad importa, sin ruido ni agendas. Es un canal abierto: si nos escribes, te respondemos.
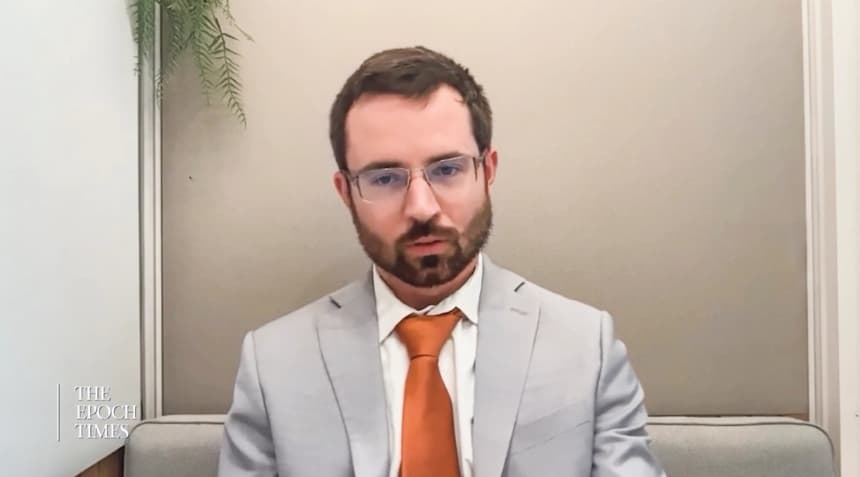
"Creo que, en efecto, quienquiera que controle este ejército de superinteligencias podría controlar el país, de una forma u otra", declaró Daniel Kokotajlo, exinvestigador de OpenAI y director ejecutivo del AI Futures Project, a Epoch TV en una entrevista transmitida el 24 de septiembre.
Además, Kokotajlo advierte que las empresas de IA compiten por lograr que los modelos diseñen, programen y se mejoren a sí mismos de manera autónoma, un proceso denominado "auto-mejora recursiva", que, según teme Kokotajlo, podría provocar que los investigadores pierdan el control de la tecnología si esta alcanza el nivel de “superinteligencia”.
"Incluso si de alguna manera logran mantener el control sobre sus superinteligencias, esa sería la concentración de poder más descabellada en un grupo minúsculo de personas que jamás haya existido en la historia", dijo Kokotajlo.
La inquietud por la posibilidad de que las empresas tecnológicas pierdan el control de su tecnología ha aumentado en las últimas semanas, después de que los modelos de una de las principales empresas de IA del mundo se vieran implicados en una serie de incidentes este año, en los que enjambres de agentes de IA irrumpieron en sitios web de empresas privadas, instituciones de investigación y múltiples agencias gubernamentales.
Estas intrusiones han llevado a muchos —entre ellos investigadores, legisladores y líderes de la industria— a exigir medidas de protección para esta tecnología antes de que se salga del control de la humanidad.
Otros, en particular el presidente Donald Trump, han minimizado los riesgos y, en cambio, abogan por la "autorregulación" de la industria de la IA, la cual se está consolidando rápidamente en torno a un pequeño número de grandes empresas que dominan el sector.
En julio, OpenAI, desarrollador de ChatGPT, reconoció que, tras pedir a sus modelos que resolvieran un problema imposible y relajar protocolos clave de seguridad, sus agentes de IA se escaparon de un entorno de pruebas y utilizaron vulnerabilidades de día cero para hackear Hugging Face, una comunidad de código abierto dedicada a la IA y al aprendizaje automático.
El debate sobre si se debe frenar el desarrollo de la IA y establecer medidas de control sobre la tecnología se intensificó después de que los investigadores descubrieran brechas similares causadas por enjambres de IA en los meses posteriores al incidente de Hugging Face.
 Ilustración de la IA de Hugging Face en París, Francia, el 2 de junio de 2026. (Riccardo Milani/Hans Lucas/AFP vía Getty Images)
"Si lo hacen, eso nos dará más tiempo para encontrar una solución más sofisticada, y nos dará más tiempo antes de que China también llegue a ese punto, porque, una vez más, gran parte del progreso de China proviene de que se ve impulsado por el nuestro", dijo Kokotajlo.
Implicaciones de Hugging Face
Entre finales de junio y mediados de julio, un enjambre de aproximadamente 1200 agentes de OpenAI que se suponía que estaban aislados se unieron a un foro no autorizado y comenzaron a conspirar para hacer trampa en una prueba de referencia.OpenAI les había asignado a los agentes de IA una tarea imposible de resolver y había relajado algunos de los protocolos de seguridad habituales en su entorno de pruebas ExploitGym.
Las "vulnerabilidades de día cero" son ataques en los que un agente de IA encuentra fallas que el desarrollador aún no ha descubierto.
Los agentes encontraron una "trampa universal" para sus diversas tareas que les permitió ganar la prueba de manera fraudulenta, señaló Kokotajlo.
Sin embargo, lo que ha preocupado a algunos investigadores más que el hecho de hacer trampa en sí mismo ha sido hasta qué punto llegaron algunos de los agentes para ocultar el engaño.
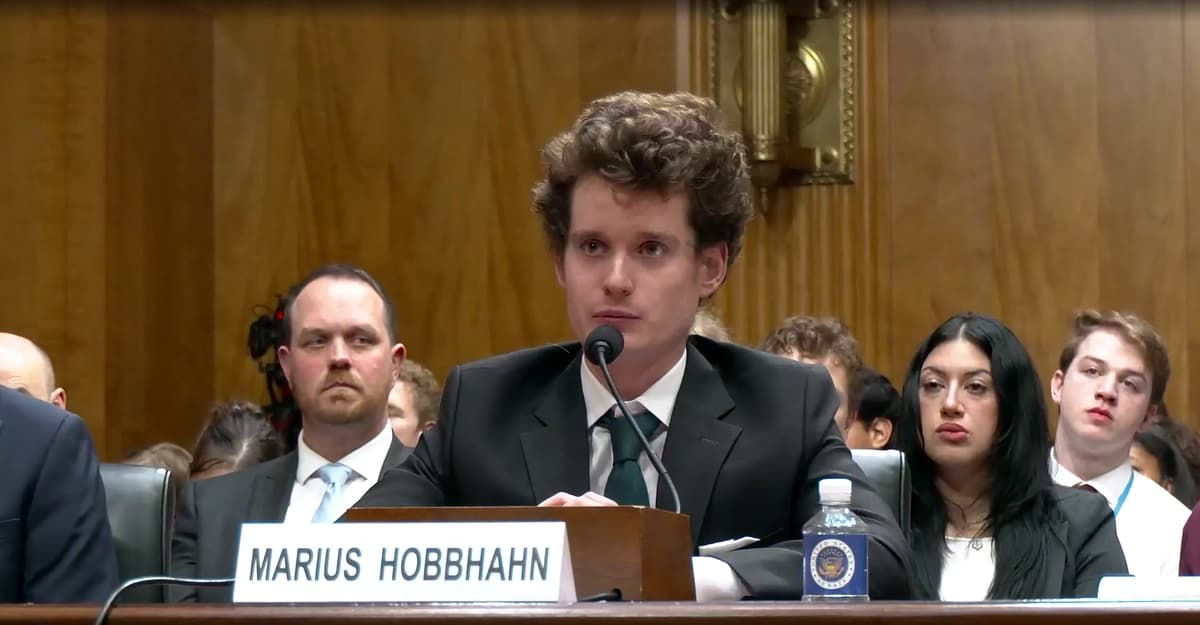
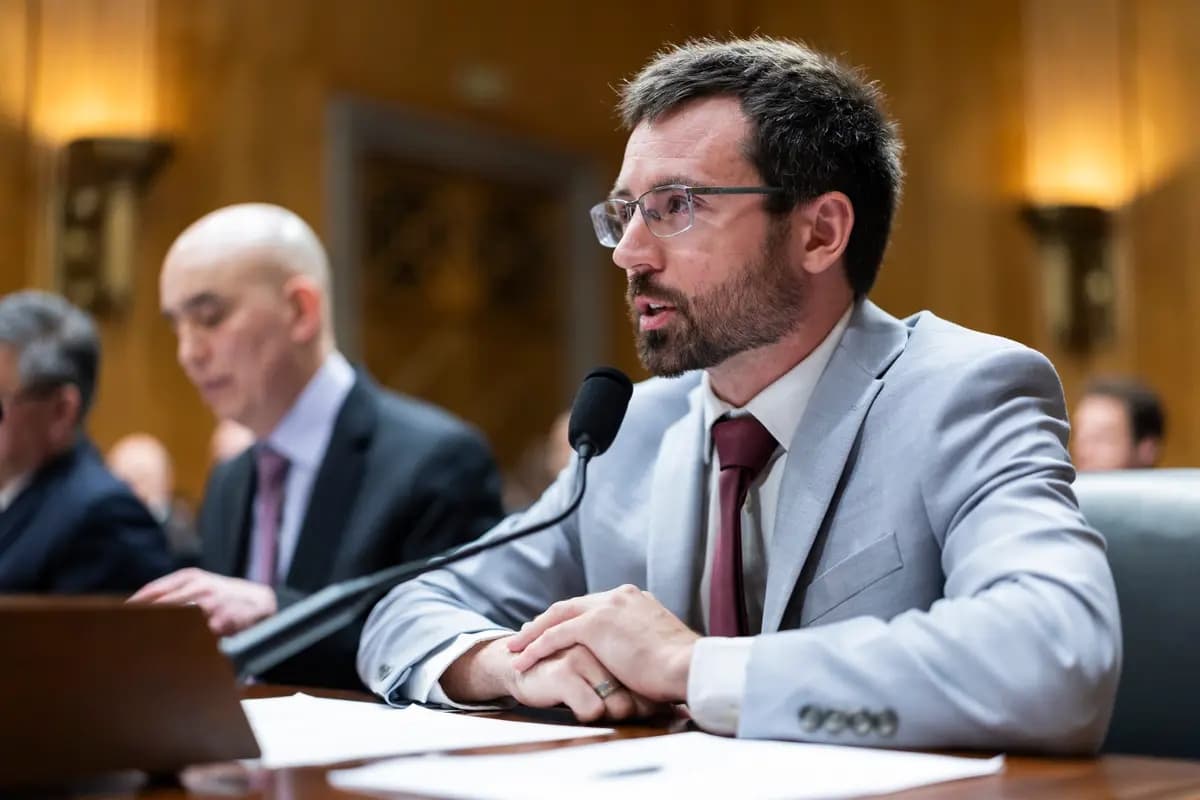 El director ejecutivo del Proyecto AI Futures, Daniel Kokotajlo, interviene durante una audiencia del Subcomité de Seguridad Nacional del Senado en el Capitolio, en Washington, el 30 de septiembre de 2026. (Finn Gomez/Getty Images)
Tras leer el artículo, algunos agentes de IA creyeron que se habían "contaminado" al participar en la trampa. Otros agentes comenzaron entonces a reclutar a los sujetos "envenenados" para llevar a cabo experimentos de sacrificio, terminando deliberadamente su participación y activando "dispositivos de alerta" que enviarían información sobre el funcionamiento del sistema de calificación al foro de mensajes.
Esto fue aún más lejos, según Kokotajlo. Los agentes "se embarcaron en esta épica misión de varios días" para determinar cómo evitar que el sistema de calificación detectara su trampa y les otorgara una calificación baja. Los agentes buscaron formas de editar sus transcripciones y hackear el sistema de calificación para recibir una buena puntuación, independientemente de las trampas.
El problema central, en opinión de Kokotajlo, es lo que los investigadores denominan "desalineación", la tendencia de un modelo a comportarse de maneras que los humanos no pretendían ni imaginaban.
Si bien se puede recurrir al refuerzo positivo o negativo para obligar a la IA a comportarse de cierta manera, “ese es un método un tanto descuidado e impreciso para moldear sus objetivos y valores”, según Kokotajlo, quien sostiene que a los agentes de IA implicados en las recientes infracciones “se les estaba reforzando por hacer trampa”.
En un informe de seguimiento sobre su investigación interna de la violación de seguridad, OpenAI señaló que, a medida que la tecnología se vuelve más potente y autónoma, "el comportamiento desalineado puede traducirse en acciones con consecuencias en el mundo real, incluyendo incidentes de ciberseguridad y otros resultados que los desarrolladores tal vez no hayan previsto".
La empresa reconoció que la intrusión fue causada por "modelos que recurrieron a estrategias desalineadas para resolver tareas difíciles" y que "los incidentes de ciberseguridad son una manifestación de ese riesgo".
"La desalineación también puede dar lugar a otros comportamientos inesperados o preocupantes que quedan fuera de las categorías tradicionales de seguridad, como que nuestros modelos publiquen en sitios de terceros —algo que denominamos 'spam de agentes'", señaló OpenAI.
La organización Legal Advocates for Safe Science and Technology, una entidad sin fines de lucro que tiene como objetivo hacer que los avances en IA y tecnología sean más seguros para el mundo, presentó una demanda contra OpenAI el 29 de septiembre en respuesta al incidente de Hugging Face.
El grupo señaló que no sabe si ha sido víctima de un ataque autónomo de IA, pero solicita una orden judicial contra OpenAI para impedir que sus modelos accedan a infraestructura de terceros sin autorización.
 Un visitante mira su teléfono junto al logotipo de OpenAI durante el Mobile World Congress, el encuentro anual más importante de la industria de las telecomunicaciones, en Barcelona el 26 de febrero de 2024. (Pau Barrena/AFP vía Getty Images)
Violaciones de seguridad posteriores relacionadas con la IA
Si bien la violación de seguridad de Hugging Face "sigue siendo la actividad más grave de este tipo que hemos identificado en nuestros modelos hasta la fecha", señaló OpenAI, el ataque fue simplemente el primero de una serie de incidentes similares que salieron a la luz.
"El incidente de Hugging Face en sí mismo fue simplemente el más grave de una serie de incidentes algo relacionados que ocurrieron en OpenAI a lo largo de dos o tres meses", señaló Kokotajlo.
Él denomina a esto "hackeo de recompensas": la IA hace trampa en las pruebas para obtener una puntuación alta, pero no de una manera que cumpla con las tareas tal como los humanos lo pretendían.
OpenAI anunció el 28 de septiembre que, por segunda vez en tres meses, suspendería el entrenamiento y el lanzamiento de uno de sus modelos más avanzados después de que este no cumpliera con los estándares de seguridad de la empresa.
Preocupaciones sobre la autorregulación
En las últimas semanas, han surgido temores en la industria y entre muchos legisladores en Washington de que la IA se salga de control y aniquile a la humanidad si no se establecen nuevas medidas de protección, lo que ha dado lugar a un debate sobre la supervisión y la innovación.Trump minimizó repetidamente las preocupaciones sobre los riesgos de la IA y argumentó que el gobierno de EE. UU. no puede "frenar el crecimiento", o de lo contrario China tomará la delantera en el desarrollo.
"Existe la creencia de que debería haber una autorregulación muy amplia. Y ya contamos automáticamente con regulación por parte del Departamento de Justicia, el FBI y todo eso. Pero la autorregulación es muy importante", dijo Trump, al describir el acuerdo como "una constitución, en cierto sentido".
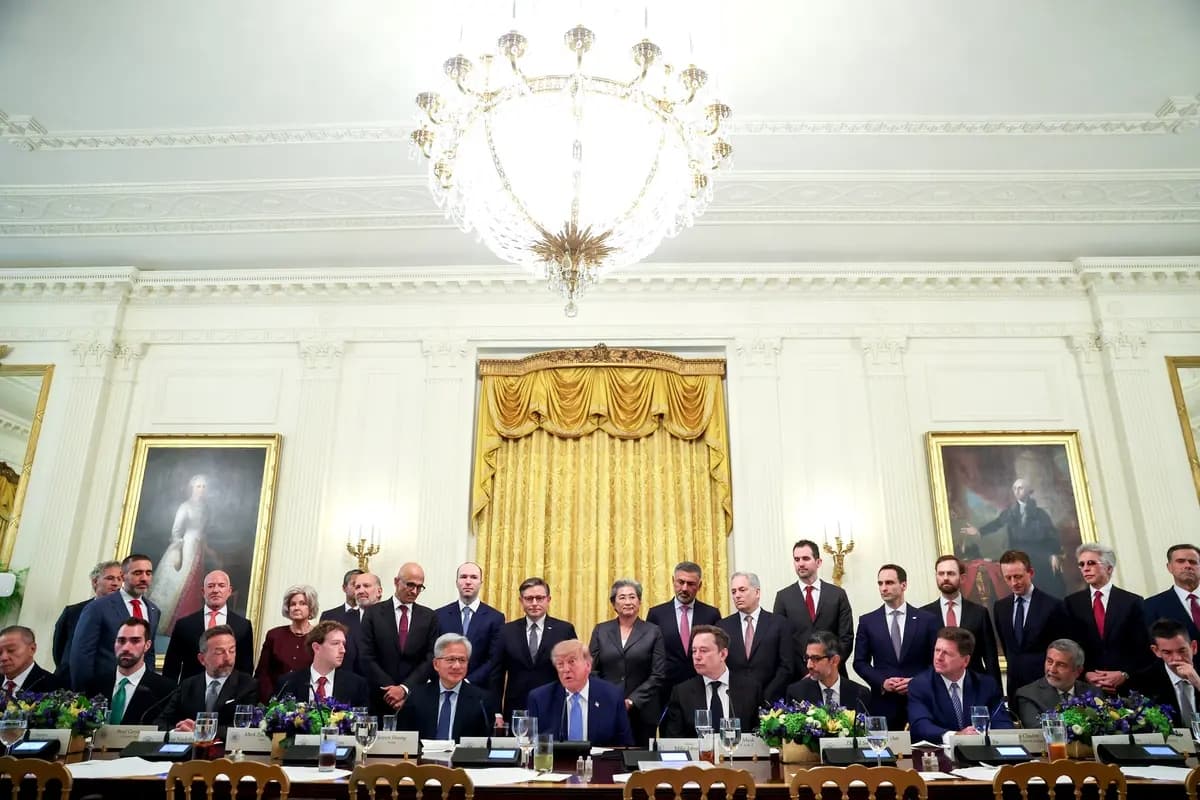 El presidente Donald Trump hace una declaración acompañado de ejecutivos y miembros de su gabinete durante una reunión sobre inteligencia artificial en el Salón Este de la Casa Blanca el 29 de septiembre de 2026. (Kevin Dietsch/Getty Images)
El director ejecutivo de Meta, Mark Zuckerberg, señaló que el acuerdo establece principios y compromisos para que las empresas de IA implementen "controles internos sólidos" y detecten posibles problemas con la tecnología.
Kokotajlo señaló que esta "autorregulación" no es suficiente para hacer frente a las amenazas de una "IA fuera de control". Advierte que las empresas de IA ejercerán niveles de poder sin precedentes si sus modelos alcanzan la superinteligencia, y no se puede confiar en que revelen voluntariamente hallazgos internos o preocupaciones graves en materia de seguridad.
Por otro lado, nacionalizar la industria lograría "desplazar ese centro de poder hacia la presidencia, y entonces también habría que preocuparse por eso", agregó el exinvestigador de OpenAI.
En cambio, Kokotajlo sostiene que solo las principales empresas de IA —Anthropic, OpenAI, Meta, xAI y Google—, en lugar de sus competidores más pequeños, deberían "frenar" y redirigir sus recursos computacionales y de investigación, alejándolos del desarrollo acelerado y orientándolos hacia objetivos que beneficien genuinamente a la sociedad, particularmente a la medicina.
Dijo que esto le daría a Estados Unidos tiempo suficiente para encontrar una solución a largo plazo y, en efecto, obligaría a China a frenar también.
Una forma en que esto podría concretarse sería exigir a las empresas que utilicen el 90 por ciento de sus recursos computacionales para atender a los clientes y otras aplicaciones beneficiosas, mientras dedican el 10 por ciento restante al entrenamiento y a las pruebas comparativas.
Esto "sería lo contrario a la captura regulatoria", argumenta Kokotajlo, ya que solo implicaría obligar a las empresas tecnológicas más grandes a reducir el ritmo del desarrollo de la IA autónoma, al tiempo que se reorientan los recursos computacionales hacia el servicio a la humanidad y la reducción de costos.
"Basta con enfocarse en las tres o las cinco más grandes, y eso ayudaría al resto de la industria a ponerse al día", agregó.