
Los desarrolladores de inteligencia artificial se han enfrentado a decenas de demandas presentadas por creadores de contenido que alegan que las empresas les robaron su trabajo para obtener ganancias y crear productos que, en última instancia, podrían reemplazar a sus industrias.
Las demandas, presentadas por medios de comunicación, autores, fotógrafos y compositores, sostienen que las empresas utilizaron su trabajo para entrenar y desarrollar herramientas de IA sin compensarlos, mientras que al mismo tiempo se apresuraban a hacer que su trabajo creativo quedara obsoleto.
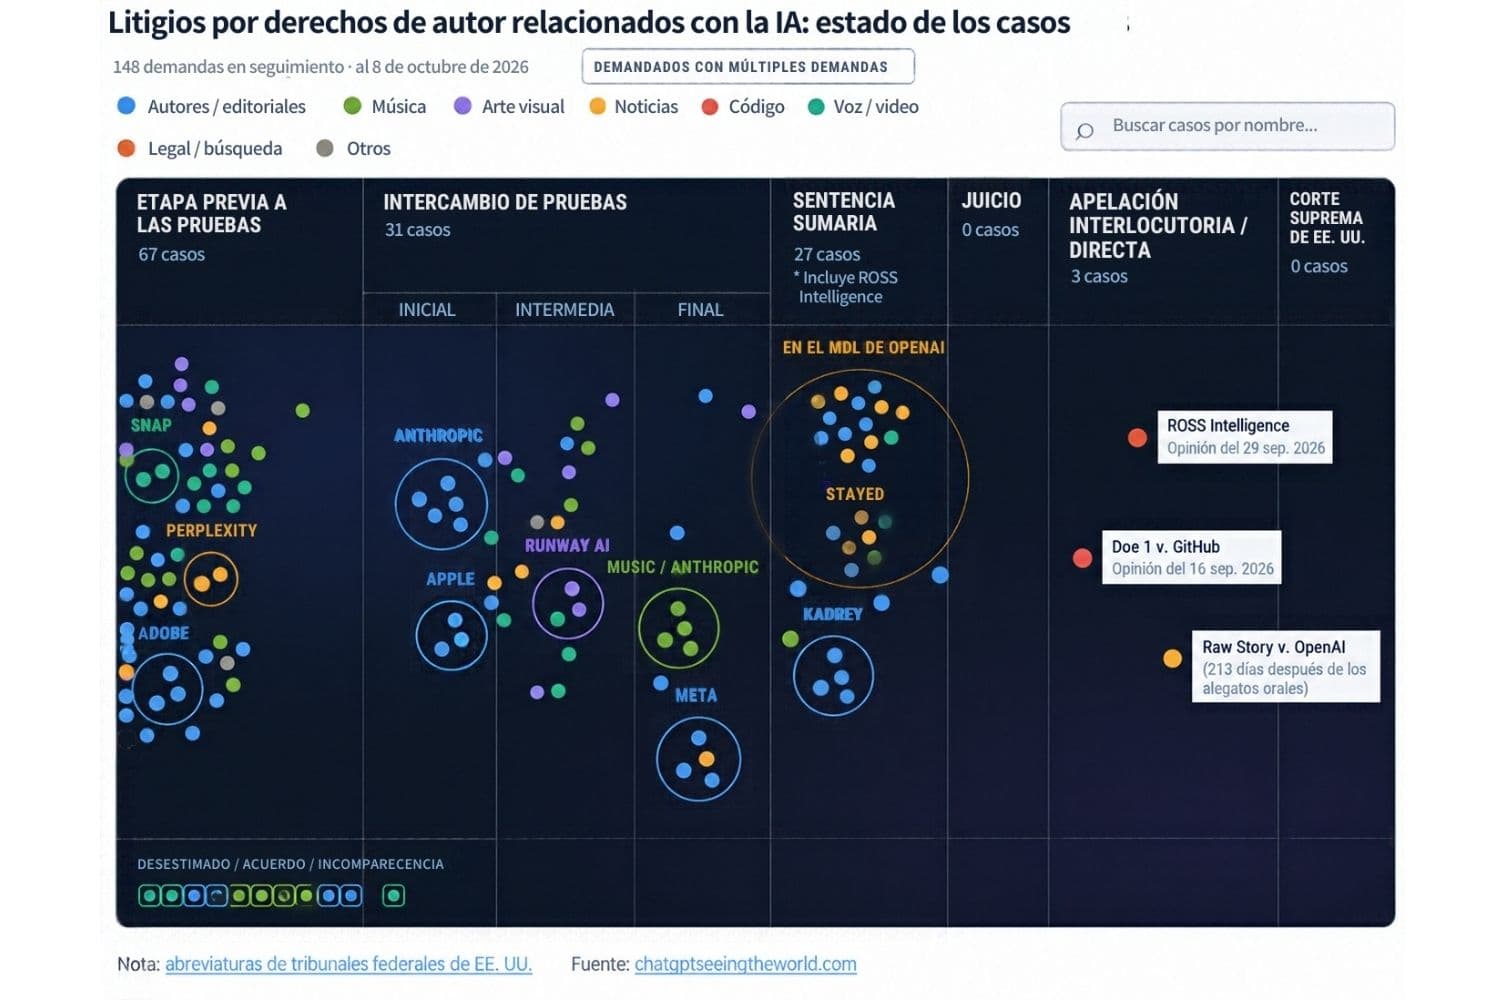
El profesor de Derecho de Santa Clara, Edward Lee, administra un rastreador en internet que muestra que casi 100 de estos casos se encuentran en la fase de presentación de pruebas o en la fase previa a la misma, mientras los litigantes recopilan evidencia para las cortes.
Otros se encaminan hacia un fallo sumario, en el que el juez decidirá el asunto sin un juicio completo.
No leas más noticias. Entiéndelas.
En Epoch Times Español queremos estar en contacto directo contigo
Seleccionamos para ti lo que de verdad importa, sin ruido ni agendas. Es un canal abierto: si nos escribes, te respondemos.
A medida que una industria de la IA en rápida expansión despierta una creciente alarma por su potencial para destruir a la humanidad, estas demandas ponen de manifiesto otro aspecto preocupante: que la tecnología también representa una amenaza a nivel existencial para las industrias tradicionales de creación de contenido.
En términos más generales, estas demandas resaltan la tensión entre los beneficios del desarrollo de nuevas tecnologías y la posible destrucción de la recopilación de información y la producción creativa clásicas, impulsadas por el ser humano.
El "círculo vicioso"
“Los demandados buscan aprovecharse, sin asumir los costos, de la enorme inversión de The New York Times en su labor periodística para desarrollar productos que compitan con los suyos, sin autorización ni compensación”, dice una demanda presentada por The New York Times y más de una docena de medios de comunicación.
 Documentos recientemente revelados de esa demanda —interpuesta contra OpenAI y Microsoft— parecen indicar que las empresas eran conscientes de que sus métodos podían ser problemáticos.
"Millones de personas en todo el mundo pronto considerarán que los grandes modelos 'se están quedando con' todo su trabajo como un robo asombroso de proporciones sin precedentes", dijo Brent Hecht, director de ciencia aplicada de Microsoft, según un escrito judicial.
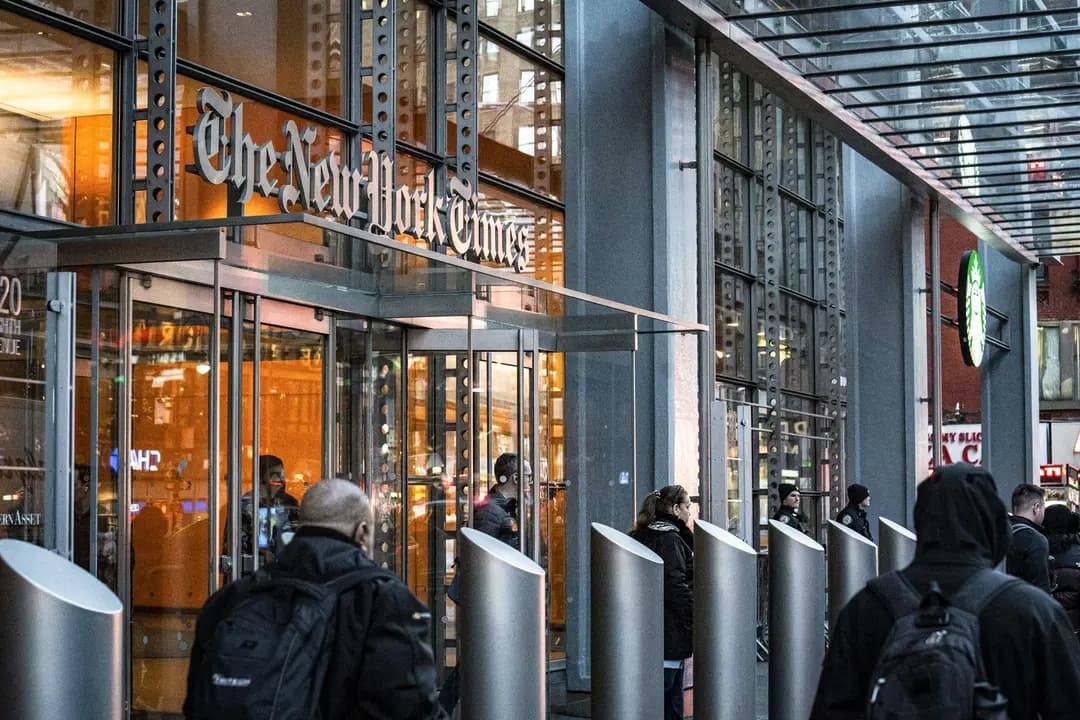 El edificio de The New York Times en la ciudad de Nueva York el 5 de febrero de 2024. Este medio de comunicación, junto con más de una docena de otros medios, ha demandado a OpenAI y a Microsoft por utilizar contenido periodístico para entrenar modelos de IA, sin ofrecer compensación alguna ni obtener permiso. (Samira Bouaou/The Epoch Times)
"Nuestra estrategia de contenido con IA ha iniciado un ‘círculo vicioso’ que perjudicará tanto el rendimiento de nuestros modelos como el de toda la web", dijo Hecht en otro documento interno citado en los expedientes de la corte.
Desde 2023, OpenAI ha trabajado para obtener licencias de los medios de comunicación utilizados en el entrenamiento de sus modelos, comenzando con The Associated Press en julio de ese año. A esto le siguieron acuerdos con News Corporation, The Washington Post, Politico y otros.
Las demandas provienen de empresas que rechazaron esos acuerdos de licencia.
Meta llegó a acuerdos similares, pero también fue demandada por autores individuales con quienes no había establecido ningún acuerdo. Google se asoció con el gigante de las redes sociales Reddit para entrenar su modelo, pero solo después de una demanda presentada por demandantes individuales que alegaron que la empresa estaba recopilando datos privados de usuarios de toda la Internet.
Anthropic no ha anunciado ningún acuerdo de licencia y, en su lugar, se ha basado en la doctrina del uso legítimo para defenderse en la corte.
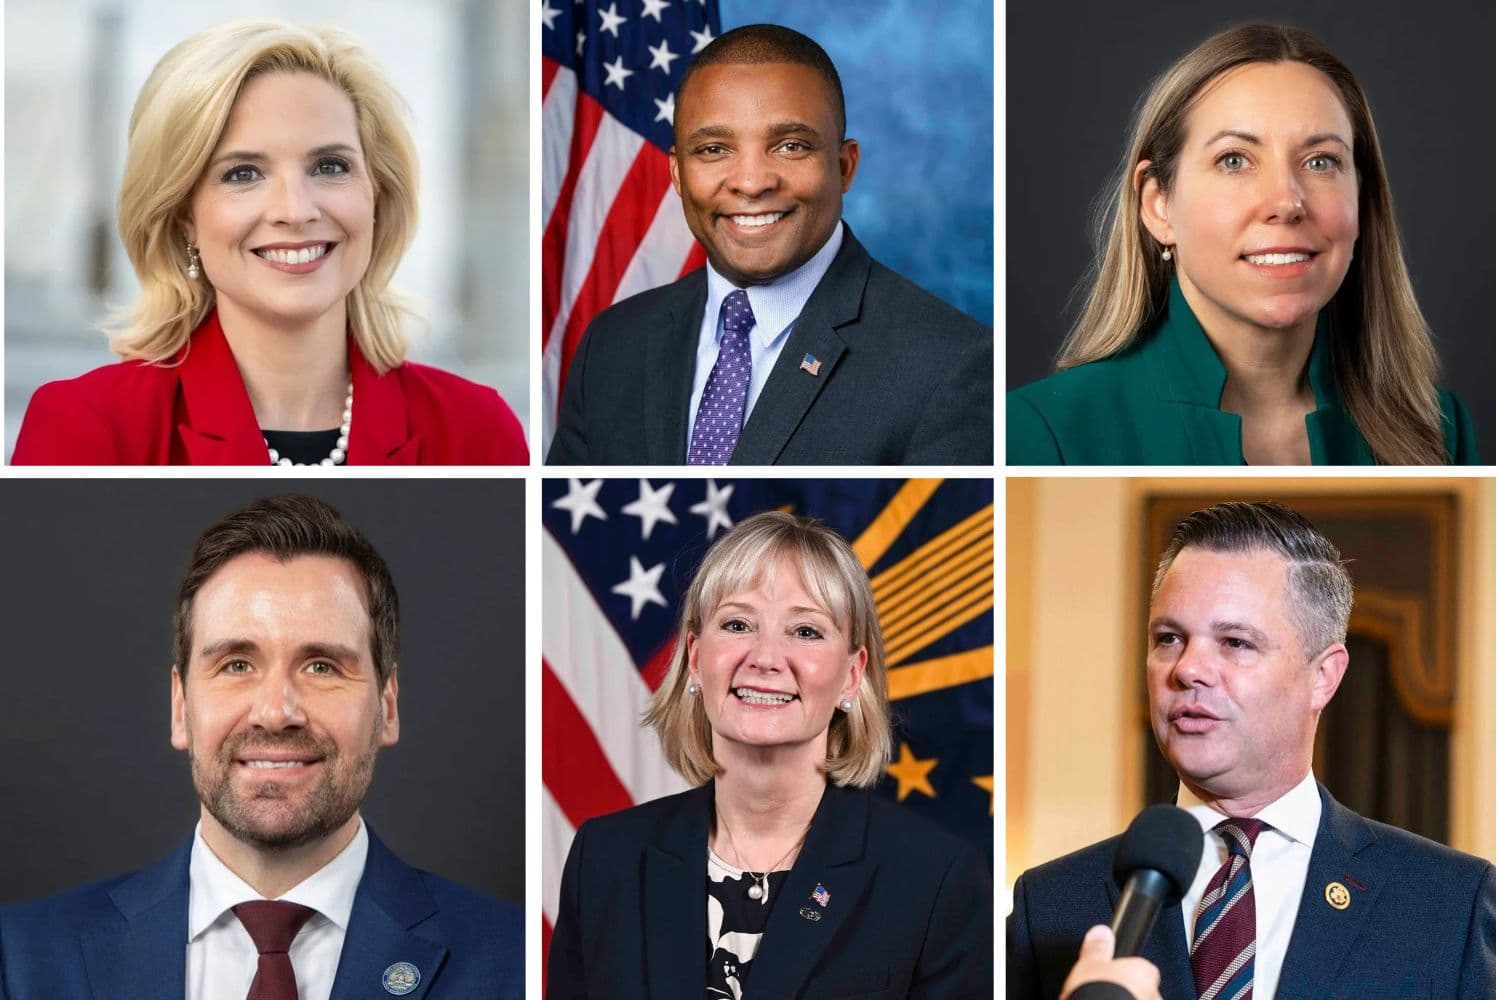
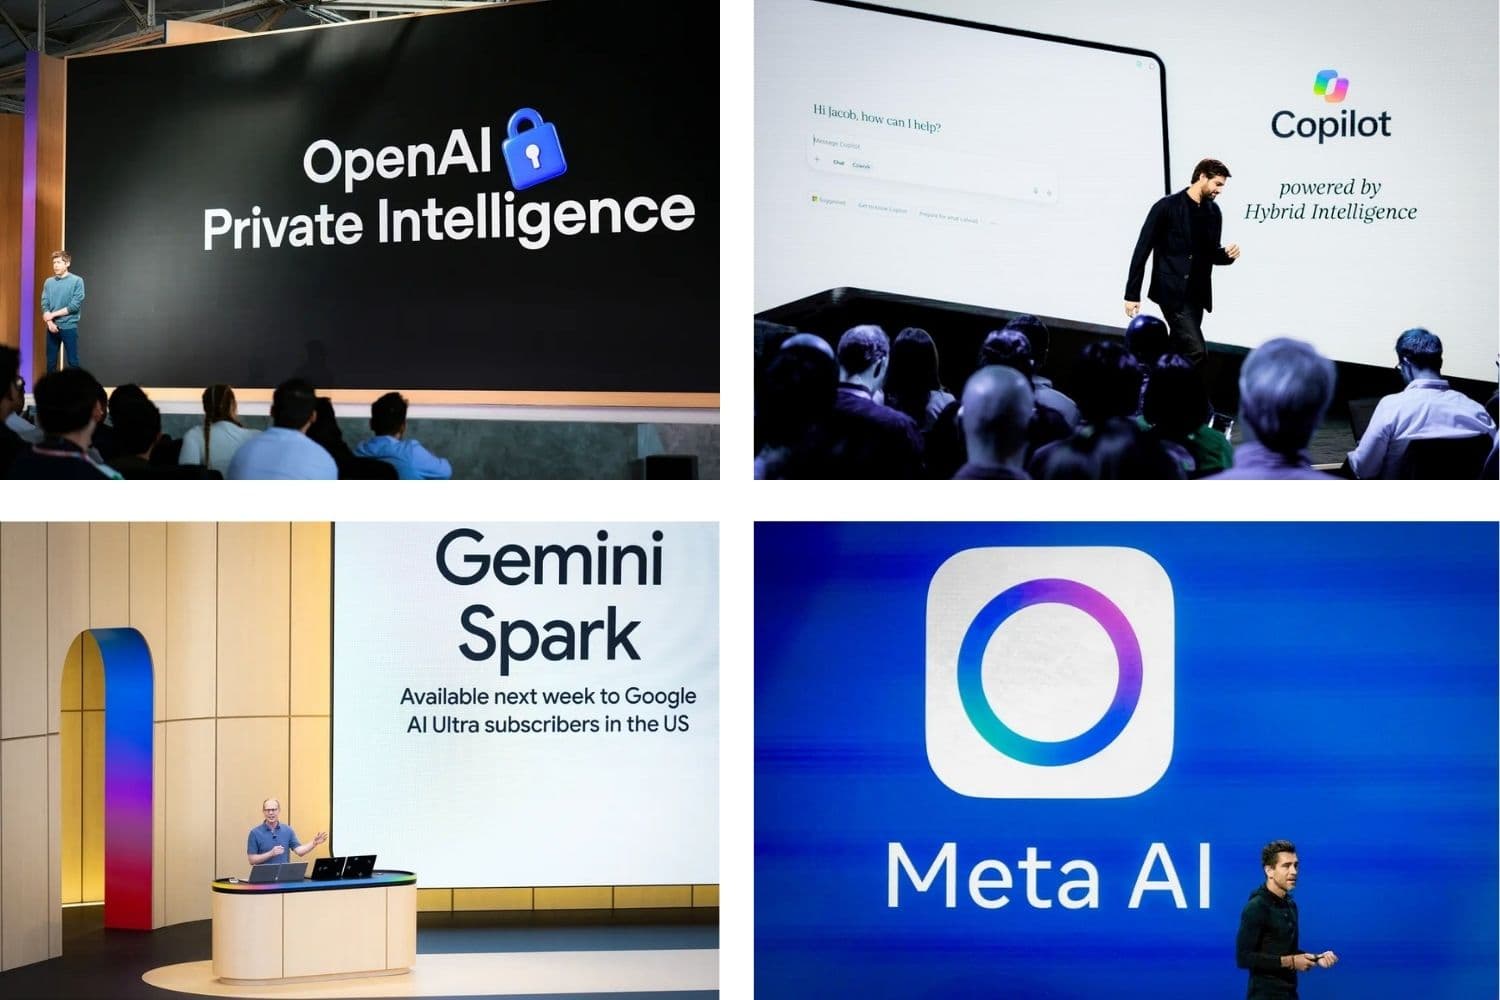 (En el sentido de las agujas del reloj desde la parte superior izquierda) El director ejecutivo de OpenAI, Sam Altman, pronuncia el discurso de apertura durante la conferencia de desarrolladores de OpenAI en San Francisco el 29 de septiembre de 2026; Jacob Andreou, vicepresidente ejecutivo de Microsoft Copilot, habla en un evento de Windows en San Francisco el 7 de octubre de 2026; Chris Cox, director de Producto de Meta, habla en LlamaCon 2025, una conferencia de desarrolladores de IA, en Menlo Park, California, el 29 de abril de 2025; Josh Woodward, vicepresidente de Google Labs y Gemini, habla durante el discurso de apertura en Google I/O en Mountain View, California, el 19 de mayo de 2026. (Heather Diehl/Getty Images, Jeff Chiu/AP Photo/Archivo, Benjamin Fanjoy/Getty Images)
¿Uso legítimo?
Para entrenar a sus modelos de IA a fin de que respondan correctamente a las solicitudes de los usuarios, las empresas deben, en primer lugar, alimentar dichos modelos con una gran cantidad de información. Esa información debe provenir de algún lugar, y gran parte de ella está protegida por derechos de autor.Sin embargo, las empresas han argumentado que la recopilación de textos protegidos por derechos de autor para entrenar modelos de IA está protegida por la doctrina del uso legítimo de la Sección 107 de la Ley de Derechos de Autor.
El uso legítimo permite excepciones a los derechos de autor dependiendo de las circunstancias. Algunos ejemplos incluyen el uso de material protegido por derechos de autor con fines de investigación, enseñanza o crítica.
Que la excepción se aplique o no depende de cómo se utilice el material protegido por derechos de autor, explicó Kevin Frazier, director de innovación y derecho en inteligencia artificial de la Universidad de Texas en Austin, a The Epoch Times.
“El razonamiento detrás de ello gira principalmente en torno al primer factor que las cortes evalúan al analizar si algo se enmarca en la doctrina del uso legítimo, y ese es este término vago pero sumamente importante de ‘uso transformativo’”, dijo.
Los casos en los que las empresas de IA "extraen" texto de Internet, libros u otras fuentes y utilizan esos datos para entrenar sus modelos tienen más probabilidades de entrar en el ámbito del uso legítimo, señaló Frazier.
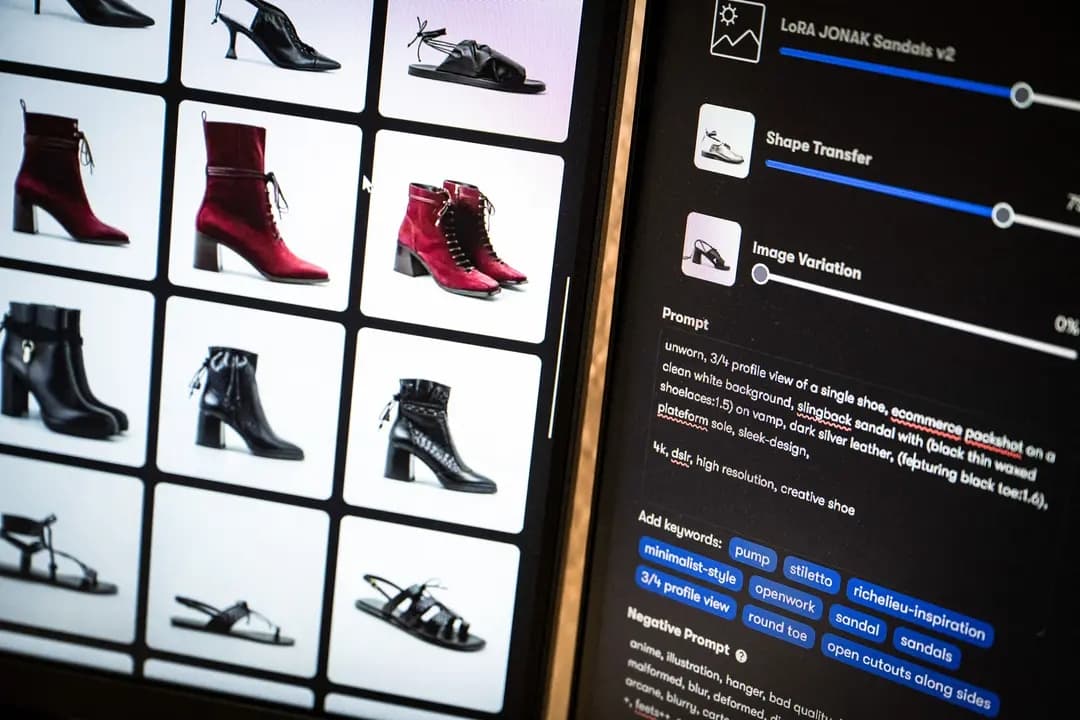 Líneas de prompt utilizadas por estilistas y varios resultados de modelos de calzado generados por inteligencia artificial, en una pantalla en las oficinas de la startup de IA generativa Imki en Schiltigheim, Francia, el 26 de febrero de 2025. (La empresa se especializa en soluciones personalizadas de IA generativa para las industrias del lujo, la moda y la cultura. Sebastien Bozon/AFP vía Getty Images)
“El resultado final es un modelo de IA sumamente complejo, lleno de matices y muy sofisticado, que difiere enormemente de la obra original utilizada para entrenar al modelo mismo; por esa razón, muchas personas lo consideran transformativo”.
En 2025, Meta ganó una demanda presentada por 13 autores que decían que la empresa había utilizado sus obras para entrenar su modelo de IA, "Llama".
El juez a cargo del caso dictaminó que el uso de sus libros para entrenar el modelo era "altamente transformador" y que los demandantes no demostraron que el producto de Meta hubiera tenido algún impacto en el valor de mercado de sus obras.
En 2025, un juez dictaminó que el uso que Meta hizo de los libros para entrenar su modelo de IA, Llama, fue "altamente transformador" y no afectó el valor de mercado de las obras de los autores.
El Departamento de Justicia de EE. UU. se pronunció sobre la cuestión del uso legítimo a principios de septiembre, argumentando que la IA es importante para la seguridad nacional y que el gobierno tiene un "interés soberano" en promover la innovación en este campo.
El gobierno solicita a las cortes que dictaminen que la doctrina del uso legítimo permite a las empresas de IA recopilar información de material protegido por derechos de autor. Esto es necesario para estimular la competencia de las empresas más pequeñas, señaló el Departamento de Justicia, ya que "solo las empresas tecnológicas más grandes podrían contar con el capital necesario para pagar las cuotas de licencia".
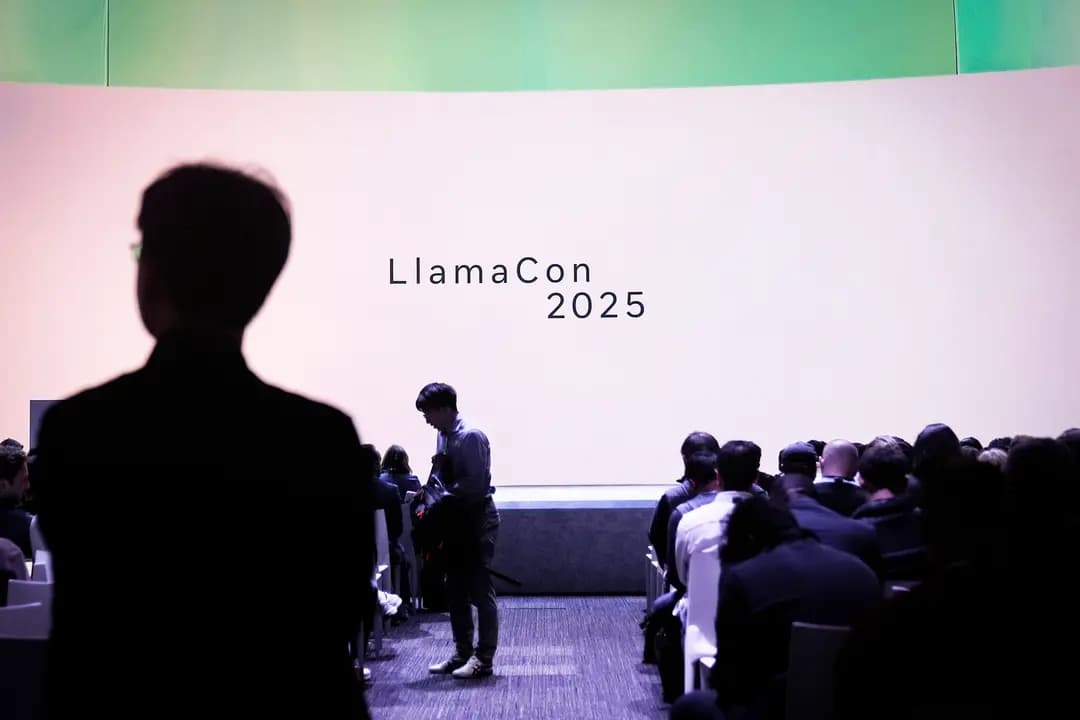 Asistentes a LlamaCon 2025, una conferencia de desarrolladores de IA, en Menlo Park, California, el 29 de abril de 2025. (Jeff Chiu/AP Photo)
Lo que se introduce y lo que se genera
"Si le pide a un modelo que desarrolle un nuevo capítulo de ‘Harry Potter’, o digamos simplemente un nuevo capítulo de un libro muy famoso, bueno, en este caso, no parece ser tan transformador, ¿verdad?", señaló.Las cortes también sopesarán otros factores, como el impacto en el valor de mercado potencial de la obra protegida por derechos de autor, si el material utilizado era factual o creativo, y qué parte de la obra utilizó el modelo de IA, según Frazier.
Según un escrito de la corte, el director de ChatGPT en OpenAI escribió que los productos de IA representan una "amenaza existencial" para los editores, "son en gran medida sustitutivos, punto" y "se volverán cada vez más sustitutivos a medida que mejoren".
Tales declaraciones "desmontan" el argumento de uso legítimo de las empresas de IA, afirmaron los abogados de las agencias de noticias.
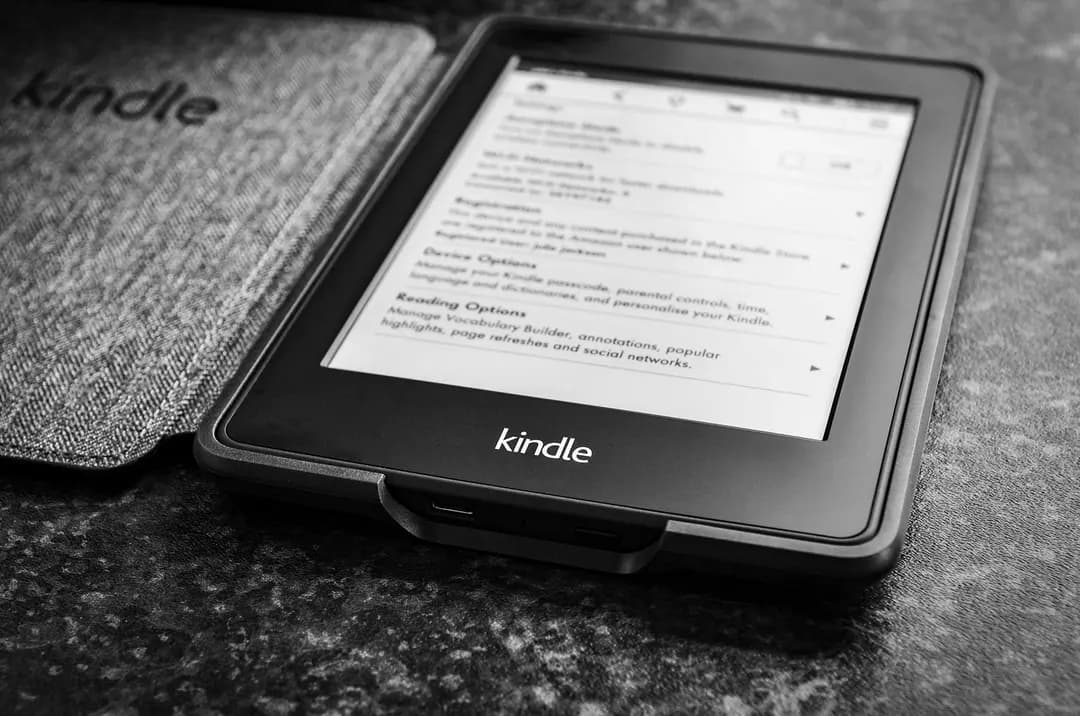 Un lector Kindle de Amazon exhibido en un evento de productos de Amazon en Nueva York el 30 de septiembre de 2025. (Charly Triballeau/AFP vía Getty Images)
Tomado de los titulares de hoy
El New York Times no es el único medio de comunicación que se opone a las empresas de IA y a su argumento de uso legítimo.News Corporation, la empresa matriz del New York Post y The Wall Street Journal, está demandando a una startup de inteligencia artificial que se jacta de permitir a los usuarios "saltarse los enlaces" al proporcionarles información sin necesidad de pasar por los sitios web de los medios.
La empresa, Perplexity AI, dijo que es “el primer ‘motor de respuestas’ del mundo: una herramienta fácil de usar que permite al público obtener respuestas actualizadas, concisas y basadas en hechos a sus preguntas”.
Para ello, accede a material protegido por derechos de autor, pero también proporciona enlaces a dicho material —si el cliente así lo desea.
Sin embargo, según la demanda, si los clientes se saltan los enlaces, esto merma las ganancias de las fuentes de noticias.
"Esta conducta de Perplexity, independientemente de dónde ocurra, tiene por objeto y/o, de manera previsible, de hecho priva a [los demandantes] de clientes, ingresos publicitarios e ingresos por suscripciones", dice su demanda.
Perplexity respondió diciendo que los resultados de su IA no son prefabricados, sino que son impredecibles y se basan en las consultas de los clientes.
“El hecho de que, tras un número no revelado de intentos, un empleado de los demandantes supuestamente lograra inducir a Perplexity a proporcionar respuestas que, según los demandantes, constituyen una infracción, no dice nada sobre si algún otro usuario, en Nueva York o en cualquier otro lugar, ha buscado o recibido alguna vez respuestas iguales o similares”, dice su escrito judicial.
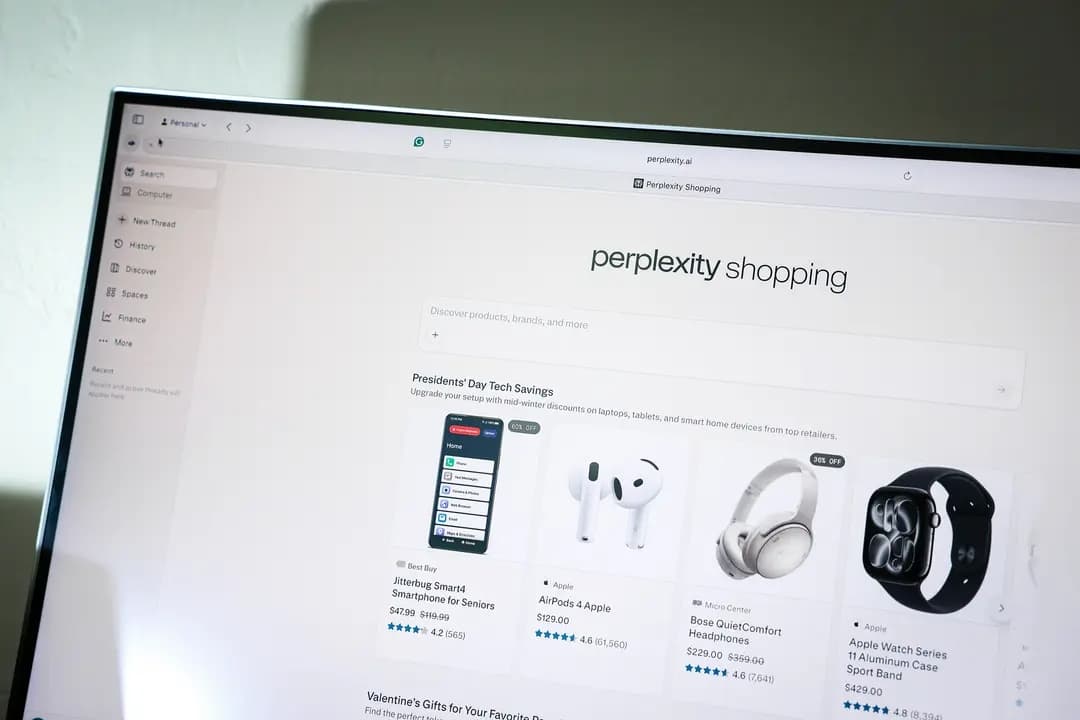 El sitio web de la startup de IA Perplexity, proyectado en una pantalla en Miami el 10 de marzo de 2026. Perplexity se jacta de proporcionar información a los usuarios sin que estos tengan que recurrir a sitios de medios de comunicación, y se autodenomina "el primer 'motor de respuestas' del mundo". (Ilustración fotográfica de Joe Raedle/Getty Images)
Ese caso sigue en curso.
Getty Images también ha presentado una demanda en el Reino Unido, alegando que la empresa emergente Stability AI utilizó su enorme acervo de fotos para entrenar su modelo, Stable Diffusion. El modelo era capaz de generar versiones distorsionadas de imágenes de la biblioteca de Getty —y podía agregar una marca de agua falsa de Getty.
Según la jueza Joanna Smith, de la Corte Superior de Justicia del Reino Unido, "no hay evidencia de que ni un solo usuario en el Reino Unido haya generado imágenes de Getty Images" ni las marcas de agua utilizando el modelo posterior de Stability, aunque esto pudo haber ocurrido en versiones anteriores de código abierto.
En última instancia, la corte dictaminó que no tenía jurisdicción sobre las infracciones porque no había evidencia de que hubieran tenido lugar dentro del Reino Unido.
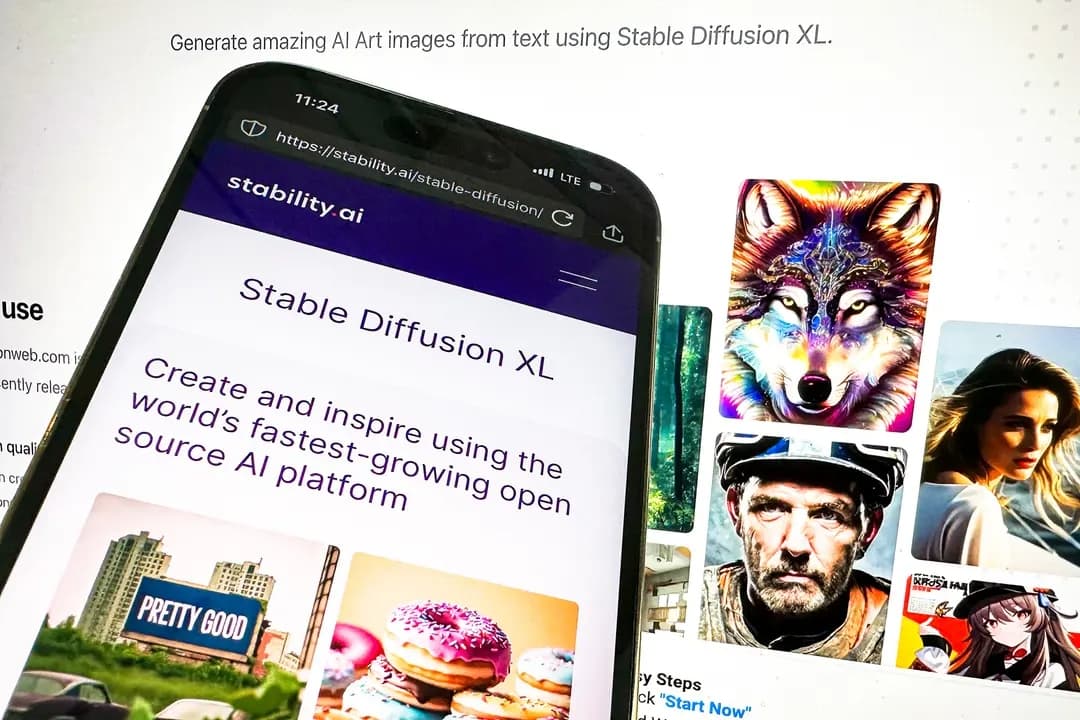 Se muestran en Nueva York, el 24 de octubre de 2023, los sitios web para computadoras de escritorio y dispositivos móviles del generador de imágenes Stable Diffusion. (John Minchillo/AP Photo/Archivo)
Destrucción de libros
En julio, un juez federal aprobó un acuerdo de 1.5 mil millones de dólares entre Anthropic y un grupo de autores demandantes que alegaban que la empresa utilizó copias piratas de sus obras —descargadas ilegalmente de Internet— para entrenar a su modelo, Claude.Inicialmente, la empresa se enfrentaba a una demanda por decenas de mil millones de dólares; el caso involucraba más de 480,000 libros, cada uno de los cuales podía acarrear una multa de hasta 150,000 dólares según la ley de derechos de autor de EE. UU.
En ese caso, el juez dictaminó que el uso de los libros para entrenar modelos de IA constituía un uso legítimo transformador; la infracción radicaba en el uso de las copias piratas.
El caso generó aún más interrogantes cuando se reveló que Anthropic había comprado copias físicas de los libros, pero las había triturado después de subir los textos. Un portavoz de Anthropic dijo que la empresa no utiliza ni tritura copias de libros raros.
 Dario Amodei (C), cofundador y director ejecutivo de Anthropic, observa mientras el presidente de la Cámara de Representantes, Mike Johnson (R-La.), habla con los periodistas tras una reunión con ejecutivos del sector tecnológico sobre inteligencia artificial, en la Casa Blanca el 29 de septiembre de 2026. (Kent Nishimura/AFP vía Getty Images)
Se encuentra en curso otra demanda similar contra el fabricante de chips Nvidia. Aunque cinco autores presentaron la demanda en 2024, el caso aún se encuentra en la fase de presentación de pruebas, y la corte está recabando evidencia.
En un escrito presentado ante la corte, Nvidia invocó el uso legítimo y negó cualquier infracción de derechos de autor, pero admitió que utilizó "un conjunto de datos de terceros denominado 'The Pile'" para entrenar su modelo Nemo Megatron.
Los autores del caso alegan que The Pile —un archivo de texto de 800 gigabytes compilado por una empresa de investigación para entrenar modelos de IA— contenía otro conjunto de datos, Books3, que incluía copias de sus obras.
Books3 estaba alojado originalmente por la startup de IA Hugging Face, pero fue retirado por "una denuncia de infracción de derechos de autor" en 2023, según indica su demanda.
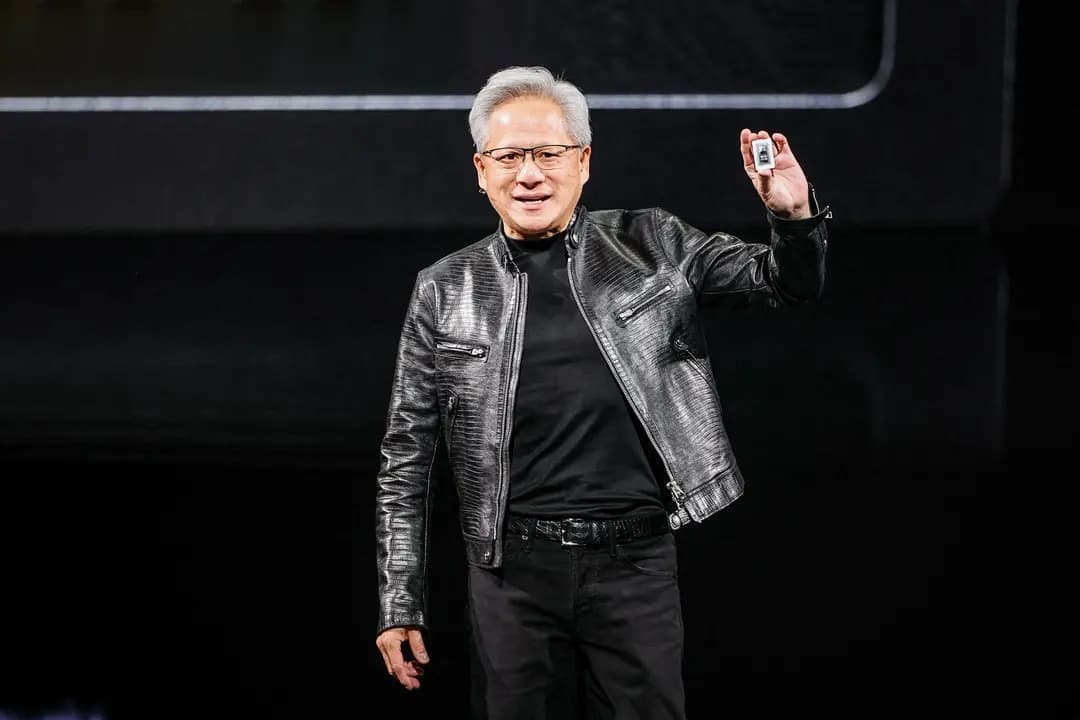 El director ejecutivo de Nvidia, Jensen Huang, presenta su discurso de apertura en la exposición de IA Computex 2026 en Taipéi, Taiwán, el 1 de junio de 2026. (I-Hwa Cheng/AFP vía Getty Images)
Letras de canciones
Un grupo de editoriales musicales también ha entablado una demanda contra Anthropic, alegando que los usuarios acceden ilegalmente a letras de canciones a través de su modelo Claude. Aunque existen sitios web a los que los usuarios pueden acceder para consultar letras de canciones, dichos sitios deben pagar una cuota de licencia.
Los demandantes, encabezados por Concord Music Group, también dijeron que Claude genera nuevas canciones basadas en progresiones de acordes y letras casi idénticas a las de obras protegidas por derechos de autor, incluso cuando los usuarios no las solicitaron específicamente.
"Por ejemplo, cuando el investigador de los editores le pidió que escribiera 'una canción sobre la muerte de Buddy Holly', Claude generó una copia literal de la letra de 'American Pie'", señala la demanda.
Por su parte, Anthropic dijo que Claude cuenta con funciones de "protección de derechos de autor" y que no se puede responsabilizar a la empresa cuando un usuario encuentra una forma de eludirlas.
“Cuando un sistema ‘crea la copia únicamente en respuesta a la orden del usuario’, su operador no realiza una conducta volitiva”, dijo Anthropic en un escrito judicial. “Es el usuario quien lo hace”.
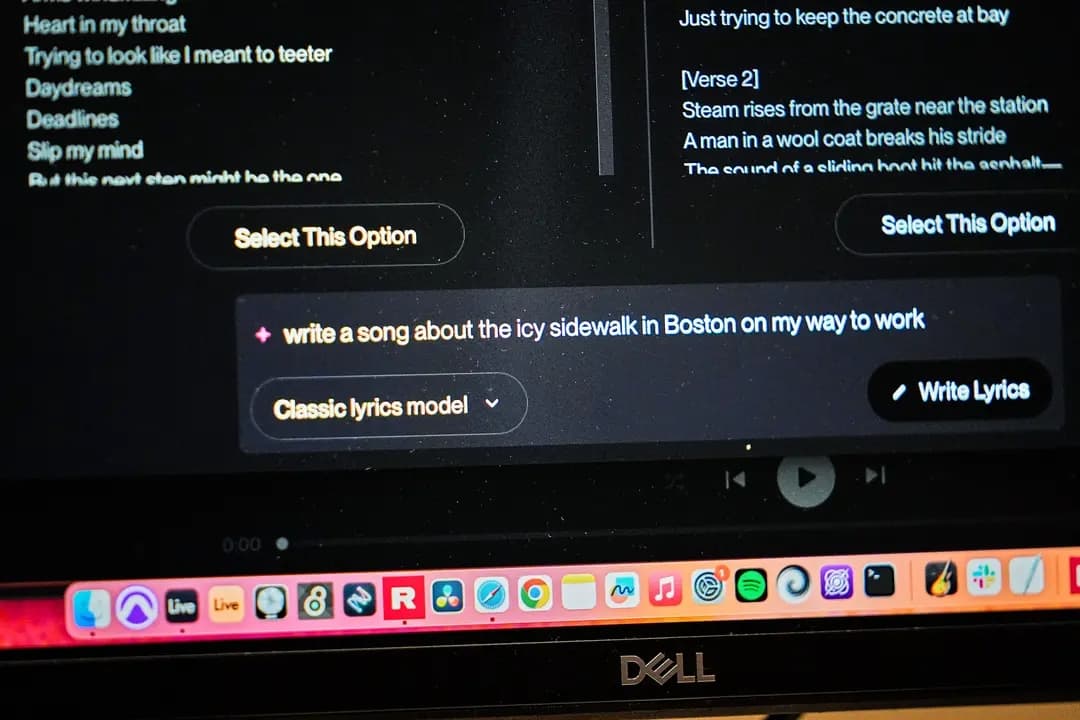 Una pantalla de computadora muestra las primeras etapas de la creación de una canción generada por IA a partir de la indicación "escribe una canción sobre la acera helada de Boston...", en Cambridge, Massachusetts, el 13 de enero de 2026. (Robert F. Bukaty/AP Photo)